RAG в Laravel: эмбеддинги, pgvector и личность, которую узнают
Идея простая: у тебя есть Telegram-канал, книги в PDF и пара сотен статей — а хочется, чтобы модель писала так, будто их автор. Не «в стиле», а именно так: с теми же метафорами, тем же ритмом и той же иронией. Для этого нужен RAG (Retrieval-Augmented Generation) — поиск релевантных фрагментов по векторному сходству и подача их модели как контекст.
В этой статье — как собрать такой конвейер в Laravel: эмбеддинги через laravel/ai, хранение в PostgreSQL с pgvector, чанкинг, инжест, поиск — и как из этого сделать узнаваемую личность.
Стек
- Laravel 12, PHP 8.3
laravel/ai— официальный пакет: провайдеры,Embeddings::,Agent- PostgreSQL + pgvector — векторы и cosine-поиск
- Postgres-образ
pgvector/pgvector:pg15вdocker-compose.yml
Никаких сторонних «RAG-фреймворков»: всё — обычные сервисы, миграции и artisan-команды.
1. Миграция: колонка vector и HNSW-индекс
Сначала расширение и таблицы:
DB::statement('CREATE EXTENSION IF NOT EXISTS vector');

Schema::create('rag_documents', function (Blueprint $table) {
    $table->id();
    $table->string('source', 32);          // telegram, book, telegraph
    $table->text('source_ref');            // уникальный ключ источника
    $table->string('title')->nullable();
    $table->string('content_hash', 64);    // sha256 контента
    $table->unsignedInteger('chunk_count')->default(0);
    // ...
    $table->unique('source_ref');
});

Schema::create('rag_chunks', function (Blueprint $table) {
    $table->id();
    $table->foreignId('document_id')->constrained('rag_documents')->cascadeOnDelete();
    $table->unsignedInteger('seq');
    $table->text('content');
    $table->unique(['document_id', 'seq']);
});
А сам вектор — отдельным DB::statement, потому что размерность известна только из конфига:
$dimensions = (int) config('rag.embedding.dimensions');

DB::statement("ALTER TABLE rag_chunks ADD COLUMN embedding vector({$dimensions})");
DB::statement('CREATE INDEX rag_chunks_embedding_idx
    ON rag_chunks USING hnsw (embedding vector_cosine_ops)');
HNSW вместо обычного ivfflat: индекс строится онлайн и не требует пересчёта при вставке новых строк. Для конвейера, куда контент приходит порциями, это ровно то, что нужно.
2. Конфигурация и DI
Всё настраиваемое живёт в config/rag.php:
'embedding' => [
    'provider'   => env('RAG_EMBEDDING_PROVIDER', 'openai'),
    'model'      => env('RAG_EMBEDDING_MODEL', 'text-embedding-3-small'),
    'dimensions' => (int) env('RAG_EMBEDDING_DIMENSIONS', 1536),
    'batch_size' => (int) env('RAG_EMBEDDING_BATCH_SIZE', 100),
],
'chunking' => [
    'target_chars'  => (int) env('RAG_CHUNK_TARGET_CHARS', 1200),
    'overlap_chars' => (int) env('RAG_CHUNK_OVERLAP_CHARS', 200),
],
'retrieval' => [
    'top_k'          => (int) env('RAG_RETRIEVAL_TOP_K', 12),
    'min_similarity' => (float) env('RAG_RETRIEVAL_MIN_SIMILARITY', 0.30),
],
Сервисы, которым нужен конфиг, регистрируются как синглтоны в AppServiceProvider:
$this->app->singleton(Embedder::class, fn () => new Embedder(
    config('rag.embedding.provider'),
    config('rag.embedding.model'),
    (int) config('rag.embedding.dimensions'),
    (int) config('rag.embedding.batch_size'),
    (int) config('rag.embedding.timeout'),
));

$this->app->singleton(Chunker::class, fn (): Chunker => new Chunker(
    (int) config('rag.chunking.target_chars'),
    (int) config('rag.chunking.overlap_chars'),
));
3. Эмбеддинги: тонкая обёртка над laravel/ai
Пакет отдаёт текст — и возвращает вектор. Обёртка нужна ровно за одно: батчинг. Провайдеры ограничены размером запроса, а документ легко разваливается на сотню чанков:
public function embedMany(array $texts): array
{
    $vectors = [];

    foreach (array_chunk($texts, $this->batchSize) as $batch) {
        $response = Embeddings::for(array_values($batch))
            ->dimensions($this->dimensions)
            ->timeout($this->timeout)
            ->generate($this->provider, $this->model);

        foreach ($response->embeddings as $embedding) {
            $vectors[] = $embedding;
        }
    }

    return $vectors;
}
Embeddings::fake() из коробки возвращает случайные векторы — это пригодится в тестах (см. раздел про тесты).
4. Чанкинг: границы абзацев, а не символов
Наивное str_split($text, 1200) режет посередине предложения и ломает смысл. Chunker работает иначе:
- нормализация переводов строк и схлопывание пустот;
- разбиение на абзацы по
\n\n; - накопление абзацев до
target_chars; - при переполнении — overlap из хвоста текущего чанка (
overlap_charsсимволов), чтобы запрос, попавший на границу, видел обе стороны; - гигантские абзацы — по предложениям (
preg_split('/(?<=[.!?…])\s+/u')).
if ($current !== '' && mb_strlen($current) + 2 + mb_strlen($piece) > $this->targetChars) {
    $chunks[] = trim($current);
    $current = $this->overlapChars > 0 ? mb_substr($current, -$this->overlapChars) : '';
}
1200 символов с оверлапом 200 — рабочий баланс: чанк достаточно самодостаточен, чтобы быть полезным изолированно, и достаточно мелок, чтобы cosine-поиск не тонул в шуме.
5. Инжест: дедупликация по хешу
RagIngestor — единственная точка входа контента в базу. Ключевая идея — sha256 от текста:
$hash = hash('sha256', $article->content);
$existing = RagDocument::query()->where('source_ref', $article->sourceRef)->first();

if ($existing !== null && ! $force && $existing->content_hash === $hash) {
    $skipped++;
    continue;   // контент не изменился — эмбеддить заново не зачем
}

$document = RagDocument::query()->updateOrCreate(
    ['source_ref' => $article->sourceRef],
    ['source' => $article->source, 'title' => $article->title, 'content_hash' => $hash, /* ... */],
);

$vectors = $this->embedder->embedMany($chunks = $this->chunker->chunk($article->content));
$this->store->replaceChunks($document, $chunks, $vectors);
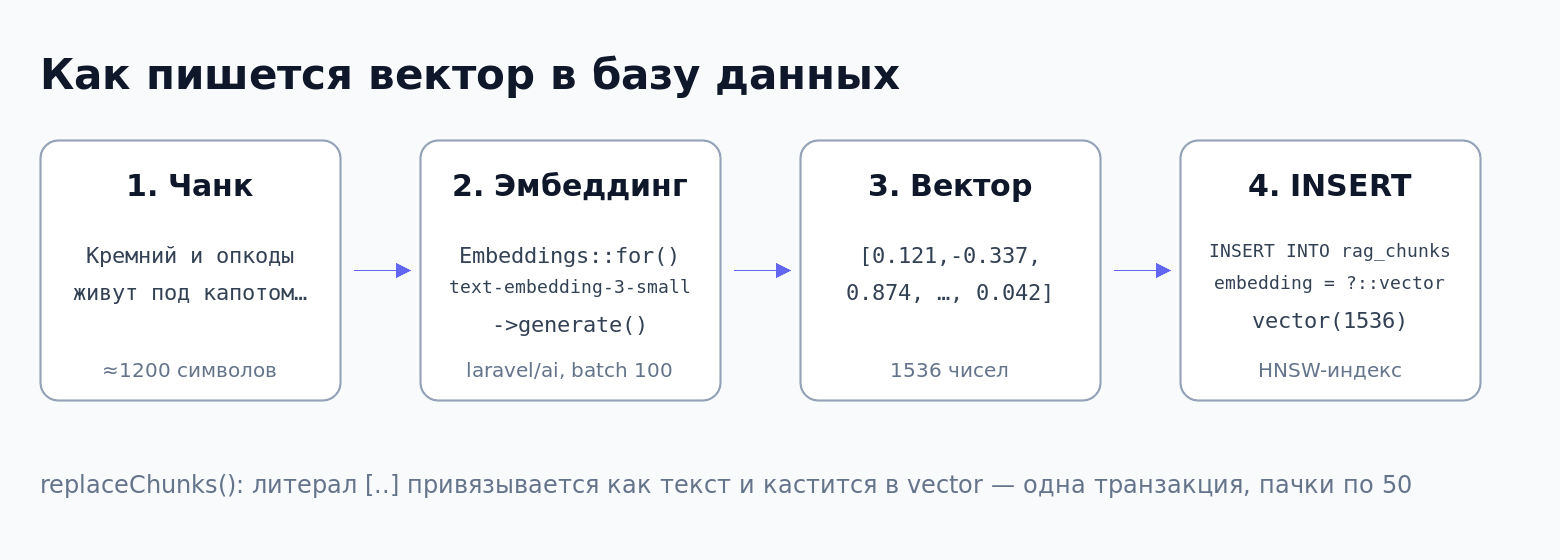
Хеширование экономит деньги: повторный ai:ingest поверх уже обжатого канала почти ничего не стоит. replaceChunks в транзакции удаляет старые чанки документа и вставляет новые пачками по 50 — либо всё, либо ничего.
6. Векторный поиск в чистом SQL
pgvector не требует ORM-магии — оператор <=> (cosine distance) в сыром запросе:
return DB::table('rag_chunks as c')
    ->join('rag_documents as d', 'd.id', '=', 'c.document_id')
    ->selectRaw('1 - (c.embedding <=> ?::vector) as similarity', [$literal])
    ->whereRaw('1 - (c.embedding <=> ?::vector) >= ?', [$literal, $minSimilarity])
    ->orderByRaw('c.embedding <=> ?::vector', [$literal])
    ->limit($limit)
    ->get();
Три детали, на которых обычно спотыкаются:
?::vector— литерал[0.1,-0.2,...]привязывается как текст и кастится в vector. Никаких JSON-обёрток.1 - distance— pgvector отдаёт расстояние (0 = совпадение, 2 = антипод). Сходство получаем вычитанием.min_similarity— порог отсекает случайные совпадения. Без негоtop_k=12всегда вернёт 12 чанков, даже если тема в базе отсутствует, и модель начнёт галлюцинировать поверх мусора.
7. Ретрив и сборка контекста
RagRetriever — два метода: retrieve() для отладки и context() для промпта. Второй собирает блоки с атрибуцией источника и укладывается в лимит символов:
### Источник: Заголовок (telegram, https://t.me/s/.../42)

<содержимое чанка>

---

### Источник: ...
Атрибуция здесь не для красоты: модель видит, откуда пришёл факт, а лимит max_context_chars (15000) не даёт контексту съесть всё окно и вытеснить инструкции.
8. Личность: агент с голосом
Эмбеддинги без личности дают сухой бота. Чтобы тексты узнавали, нужен второй компонент — агент с продуманным промптом. В laravel/ai это контракт Agent:
class KasperskyAgent implements Agent, HasProviderOptions
{
    use Promptable;

    public function __construct(private readonly string $instructions) {}

    public function instructions(): string
    {
        return $this->instructions;
    }

    public function temperature(): float
    {
        return 0.85;
    }
}
Инструкции приходят извне — ретрив подставляет свой контекст, агент не знает ничего наизусть. temperature выше стандартных 0.7: личность живёт на границе, где ещё есть вариативность, но фактография держится на контексте.
Что делает промпт «личностью», а не «инструкцией»:
- Негативный список сильнее позитивного. Запрет «В этой статье мы рассмотрим», «давайте разберёмся», «в заключение» стоит дороже любого «будь креативен» — ИИ-клише выдаёт модель мгновенно.
- Сигнальные детали.
crc = 0xEDB88320, запах канифоли, старая машина — конкретика, которую нельзя сгенерировать по шаблону. - Ритм как требование. «Чередуй рубленые короткие предложения с длинными, текучими» — это инструкция, которая физически ломает ровный «модельный» тон.
- Few-shot через контекст. Оригинальные тексты подаются в промпте не как примеры для копирования, а как материал для калибровки: «сначала молча пойми ритм… не копируй дословно».
- Запрет представляться. Модель не должна писать «Крис Касперски» — имя проставит контекст публикации.
Сборка — в ArticleWriter:
public function write(string $topic, ?int $topK = null): string
{
    $context = $this->retriever->context($topic, $topK, config('rag.writer.max_context_chars'));

    $response = (new KasperskyAgent($this->instructions($context)))->prompt(
        "Напиши статью на тему: {$topic}",
        provider: config('rag.writer.provider'),
        model: config('rag.writer.model'),
    );

    return trim($response->text);
}
Контекст и инструкции сливаются в одно instructions(), запрос — короткий. Так проще тестировать и проще менять провайдера: смена RAG_WRITER_MODEL в .env ничего не ломает.
9. Команды
Конвейер живёт в artisan:
# telegram-канал + книги в Postgres
php artisan ai:ingest all

# докрутить перекрёстные ссылки из telegra.ph
php artisan ai:ingest-links --depth=2

# посмотреть, какие чанки реально матчатся по запросу
php artisan ai:ask "что насчёт выравнивания структур" --top-k=5

# сгенерировать статью и сохранить в файл
php artisan ai:write "жизнь под капотом PE-заголовка" --save=storage/app/public/blog/pe/index.md
ai:ask — главный инструмент отладки: если по запросу возвращается мусор, дело в чанкинге или пороге min_similarity, а не в модели.
10. Источники: Крис Касперски
Голос агента не выдуман промптом — он собран из реальных текстов Криса Касперски (1976–2017) — русского хакера, реверс-инженера и автора книг о низкоуровневом программировании и дизассемблировании. Именно его тексты задают ритм, иронию и манеру деконструкции тем, которые потом воспроизводит ArticleWriter.
Телеграм-канал — https://t.me/KasperskyKris. Читается через веб-превью t.me/s/..., поэтому API-токен не нужен: имя канала задаётся в RAG_TELEGRAM_CHANNEL.
Книги (PDF) — кладутся в каталог RAG_BOOKS_PATH; доступны для скачивания прямо отсюда:
| Книга | Файл |
|---|---|
| «Фундаментальные основы хакерства. Искусство дизассемблирования» | |
| «Тонкости дизассемблирования» | |
| «C-трюки от мыщъх'а», 5-й выпуск |
Оба источника обживаются одной командой: php artisan ai:ingest all.
11. Тесты без API-ключей
laravel/ai умеет подменять и эмбеддинги, и агента:
it('generates an article using the retrieved context', function () {
    Embeddings::fake();
    KasperskyAgent::fake(['ГОТОВАЯ СТАТЬЯ']);

    app(RagIngestor::class)->ingest([/* ... */]);

    $text = app(ArticleWriter::class)->write('о кремнии', 5);

    expect($text)->toBe('ГОТОВАЯ СТАТЬЯ');

    KasperskyAgent::assertPrompted(
        fn ($prompt) => $prompt->contains('о кремнии')
            && str_contains($prompt->agent->instructions(), 'кремний')
    );
});
Пайплайн — инжест, чанки, ретрив, промпт — проверяется в Postgres-тестах без единого платного запроса. Единственное требование — RefreshDatabase и работ pgvector.
Итог
Полный конвейер — это пять классов и одна миграция:
| Этот шаг | Класс |
|---|---|
| Резка текста | Chunker |
| Текст → вектор | Embedder |
| Вектор → Postgres | VectorStore |
| Вопрос → контекст | RagRetriever |
| Контекст → текст | ArticleWriter + KasperskyAgent |
Ничего магического: cosine-расстояние в SQL, батчи наружу и промпт, в котором запрещено больше, чем разрешено. Остальное — детали, которые видно только на своих данных: подкрутить target_chars, поднять min_similarity, дать агенту на пару абзацев больше контекста. И да — эмбеддинги делают поиск, но личность делает то, что ищут читатели.